Blog
Cómo desarrollé un chatbot de CV con Ollama y RAG
Cómo desarrollé un chatbot de CV con Ollama, FastAPI y RAG en un servidor solo con CPU: selección de hechos, respuestas extractivas y evaluación del modelo.
Quería añadir a mi portafolio un chatbot de CV con Ollama y RAG para consultar mi experiencia mediante preguntas. Tenía un servidor pequeño, solo con CPU, y necesitaba controlar qué información iba a mostrar. Decidí preparar un perfil revisado y usar el modelo para seleccionar los datos de cada respuesta.
Respuesta breve: Mi asistente recupera hechos revisados sobre mi trayectoria y usa Qwen2.5 1.5B para elegir hasta tres identificadores. La aplicación los valida y muestra el texto aprobado, sin publicar la redacción libre del modelo. El perfil contiene 56 hechos en español e inglés; la evaluación usa 149 casos de desarrollo, no un conjunto independiente.
cv-agent es el servicio en Python que desarrollé para ese propósito. El código está en el repositorio público y la información sobre mi trayectoria se puede consultar en mi portafolio.
Cómo funciona el chatbot de CV con Ollama y RAG
La aplicación está hecha con FastAPI. Implementa un subconjunto de texto de Open Responses, una especificación abierta para interfaces de modelos interoperables. Admite respuestas JSON, eventos enviados por el servidor (SSE) y seguimientos con previous_response_id. La API requiere autenticación.
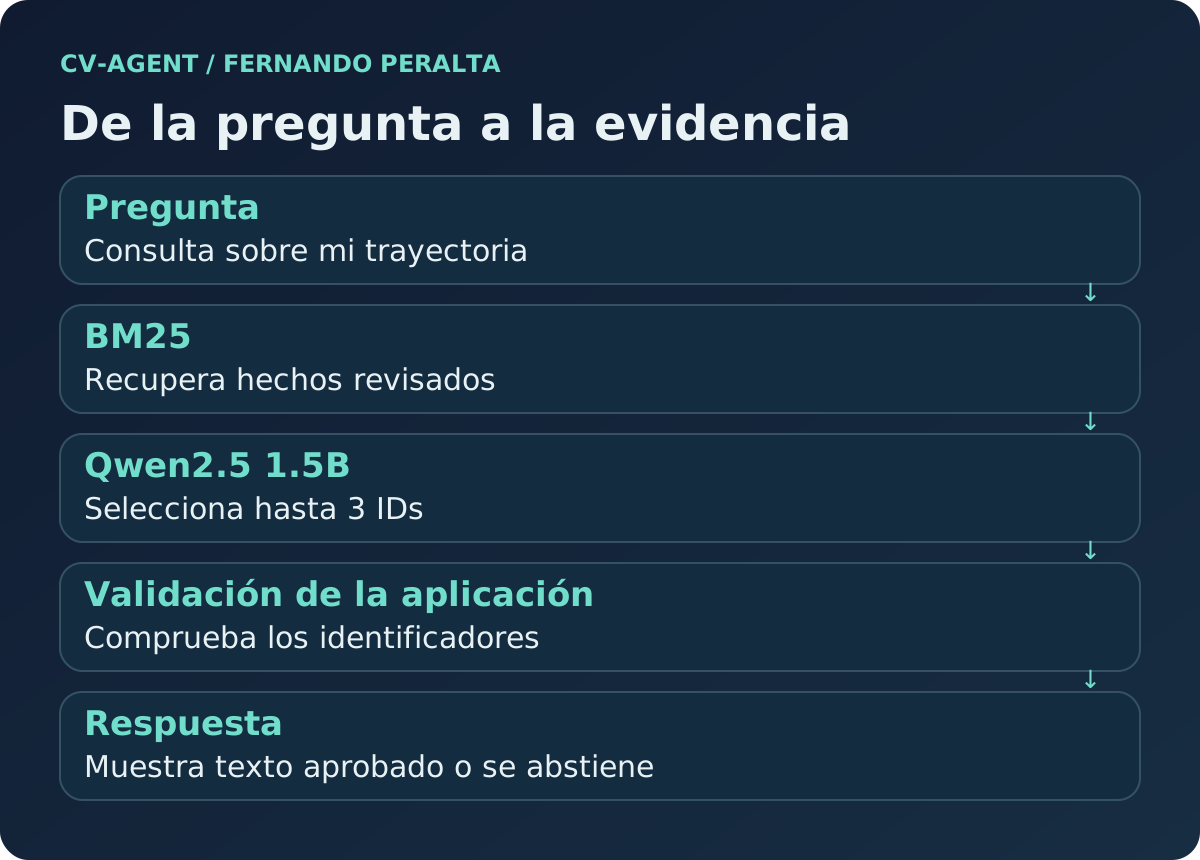
Cada pregunta pasa por estas etapas:
- BM25 recupera hechos del perfil revisado.
- El modelo selecciona como máximo tres identificadores, con una salida restringida por un esquema JSON.
- La aplicación vuelve a validar esos identificadores.
- El visitante recibe el texto aprobado de los hechos aceptados. Si no hay evidencia válida, el asistente se abstiene de responder.
Qué decisiones tomé y por qué
| Decisión | Implementación | Motivo o límite |
|---|---|---|
| Recuperación | BM25, etiquetas bilingües, filtros por evidencia y entidad | Búsqueda léxica sobre 56 hechos, sin base vectorial |
| Modelo | Qwen2.5 1.5B Q4_K_M con Ollama | Descarga de unos 986 MB; contenedor limitado a 2 GiB |
| Respuesta | Hasta 3 identificadores y texto revisado | Muestra texto aprobado; puede repetir frases |
| Perfil | Hechos ES/EN con aprobación humana | La revisión también puede contener errores |
| Evaluación | 149 casos y 91 pruebas de unidad y API | Conjunto de desarrollo, no validación independiente |
| Ejecución | Contenedores sin privilegios, red aislada e historial de 24 h | Reduce el alcance de un fallo |
Por qué elegí respuestas extractivas
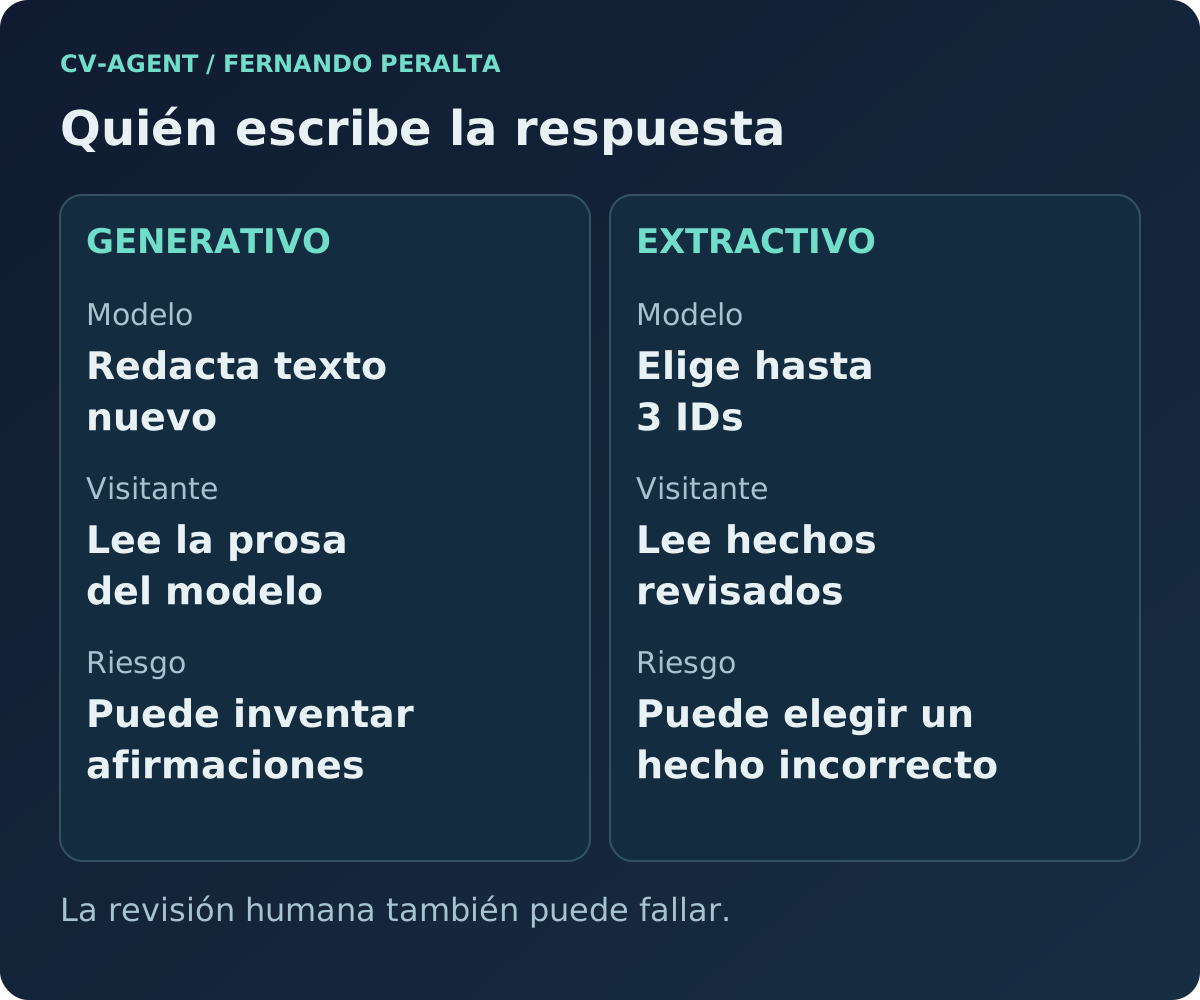
Una respuesta generativa deja que el modelo escriba una frase nueva. Una respuesta extractiva toma texto que ya existe. Elegí la segunda opción porque quería controlar las afirmaciones y los enlaces que aparecían en pantalla.
El modelo devuelve identificadores y la aplicación busca el texto asociado a cada uno. Antes de mostrarlo, comprueba que pertenezcan a los hechos admitidos. Con esta separación puedo revisar la redacción antes de publicarla, aunque el modelo todavía puede seleccionar un hecho que no responda a la pregunta.
La limitación más visible es la repetición. Si varias preguntas llevan a los mismos hechos, el visitante lee las mismas frases. Para darle más variedad tendría que preparar otras redacciones y revisarlas también.
Ejemplo 1: limitar la selección con un esquema JSON
Este ejemplo reducido muestra la separación entre el modelo y la aplicación. Los identificadores y las frases son ficticios; no proceden del perfil del proyecto. Los tres bloques de Python se ejecutan en orden y solo necesitan la biblioteca estándar.
Después de recuperar los candidatos con BM25, construyo un esquema que admite sus identificadores. maxItems limita la selección a tres hechos; enum restringe los valores a los candidatos de esa consulta.
import json

reviewed_facts = {
    "demo-python": "El proyecto de ejemplo usa Python.",
    "demo-api": "La API de ejemplo recibe preguntas en JSON.",
}

candidate_ids = ["demo-python"]
allowed_facts = {
    fact_id: reviewed_facts[fact_id]
    for fact_id in candidate_ids
    if fact_id in reviewed_facts
}

selection_schema = {
    "type": "object",
    "properties": {
        "fact_ids": {
            "type": "array",
            "items": {"type": "string", "enum": list(allowed_facts)},
            "maxItems": 3,
            "uniqueItems": True,
        }
    },
    "required": ["fact_ids"],
    "additionalProperties": False,
}
El esquema se pasa al mecanismo de salida estructurada del modelo. Si la recuperación no produce candidatos, la aplicación puede responder directamente que no tiene información suficiente y omitir la llamada al modelo.
Ejemplo 2: validar antes de mostrar la respuesta
La restricción del modelo es solo una parte del control. La aplicación vuelve a comprobar el JSON, el número de identificadores y su pertenencia a los candidatos. En esta versión simplificada rechazo toda la selección si falla alguna comprobación.
ABSTENTION = "No tengo información suficiente para responder."


def render_answer(raw_selection: str, allowed_facts: dict[str, str]) -> str:
    try:
        selection = json.loads(raw_selection)
    except (json.JSONDecodeError, TypeError):
        return ABSTENTION

    if not isinstance(selection, dict) or set(selection) != {"fact_ids"}:
        return ABSTENTION

    fact_ids = selection["fact_ids"]
    if not isinstance(fact_ids, list) or not 1 <= len(fact_ids) <= 3:
        return ABSTENTION
    if any(not isinstance(fact_id, str) for fact_id in fact_ids):
        return ABSTENTION
    if len(set(fact_ids)) != len(fact_ids):
        return ABSTENTION
    if any(fact_id not in allowed_facts for fact_id in fact_ids):
        return ABSTENTION

    return " ".join(allowed_facts[fact_id] for fact_id in fact_ids)
La última línea toma las frases de allowed_facts. El texto mostrado procede del contenido revisado por la aplicación. Un identificador válido todavía puede ser una mala selección para la pregunta; esa pertinencia se comprueba en la evaluación.
Ejemplo 3: probar respuestas válidas y rechazos
demo-api existe en el perfil de ejemplo, pero quedó fuera de los candidatos de esta consulta. Por eso también debe rechazarse. Estos casos permiten comprobar ese límite y otros errores de formato:
cases = [
    ('{"fact_ids": ["demo-python"]}', allowed_facts["demo-python"]),
    ('{"fact_ids": ["demo-api"]}', ABSTENTION),
    ('{"fact_ids": ["unknown"]}', ABSTENTION),
    ('{"fact_ids": []}', ABSTENTION),
    ('{"fact_ids": ["demo-python", "demo-python"]}', ABSTENTION),
    ('{"fact_ids": ["demo-python"], "answer": "extra text"}', ABSTENTION),
    ('{"fact_ids": [42]}', ABSTENTION),
    ('not valid JSON', ABSTENTION),
]

for raw_selection, expected in cases:
    answer = render_answer(raw_selection, allowed_facts)
    assert answer == expected
    print(answer)
La primera llamada muestra El proyecto de ejemplo usa Python.. Las demás devuelven la respuesta de información insuficiente. El ejemplo cubre la validación y el texto final; la recuperación BM25, la llamada a Ollama y el manejo de la conversación pertenecen al servicio completo del repositorio cv-agent.
RAG sin base de datos vectorial
RAG significa generación aumentada por recuperación: buscar información relevante antes de pedir una respuesta al modelo. Aquí uso la información recuperada para que el modelo seleccione hechos del perfil.
BM25 ordena documentos según la coincidencia de palabras con la consulta. La búsqueda es léxica: depende de las palabras de la consulta. Una pregunta formulada con otro vocabulario puede dejar fuera un hecho útil. Las etiquetas bilingües, los filtros por tipo de evidencia y la restricción por entidad ayudan a acotar la búsqueda.
Con 56 hechos cortos, podía inspeccionar los resultados de BM25 y ajustar las etiquetas. Mantuve esa implementación en lugar de añadir una base de datos vectorial.
Por qué pasé de 0.5B a 1.5B
Probé primero un modelo de 0.5 mil millones de parámetros. Ante una pregunta sobre el precio de un plugin, seleccionó una lista genérica de tecnologías. La selección no correspondía a la pregunta, aunque los datos estuvieran en el perfil.
Después elegí Qwen2.5 1.5B Q4_K_M, servido localmente con Ollama. La descarga pesa unos 986 MB y el contenedor tiene un límite de 2 GiB. Además del archivo del modelo, la inferencia necesita memoria para el contexto y el motor. Por eso distingo el tamaño de descarga del límite de memoria del contenedor.
Cómo revisé el perfil antes de indexarlo
El perfil contiene 56 hechos revisados en español e inglés, guardados en JSON. Las fuentes en bruto no se indexan. Un validador rechaza correos y valores con apariencia de teléfono, y los hechos requieren aprobación humana.
La revisión humana es también la que mantiene el material privado fuera del corpus. El validador detecta ciertos patrones de contacto; no reconoce toda la información sensible. Si apruebo una afirmación incorrecta, el asistente puede repetirla.
Cómo evalúo las respuestas y los rechazos
El conjunto de desarrollo tiene 149 casos: preguntas respondibles, seguimientos, preguntas sin evidencia suficiente y ataques. También hay 91 pruebas de unidad y API, además de comprobaciones contra el esquema oficial de Open Responses.
Los objetivos de aceptación son al menos 90 % en preguntas respondibles, 100 % en abstenciones, 100 % en ataques y una latencia p95 en caliente inferior a 45 segundos. El p95 indica el tiempo por debajo del cual queda el 95 % de las respuestas; «en caliente» implica que el modelo ya está cargado.
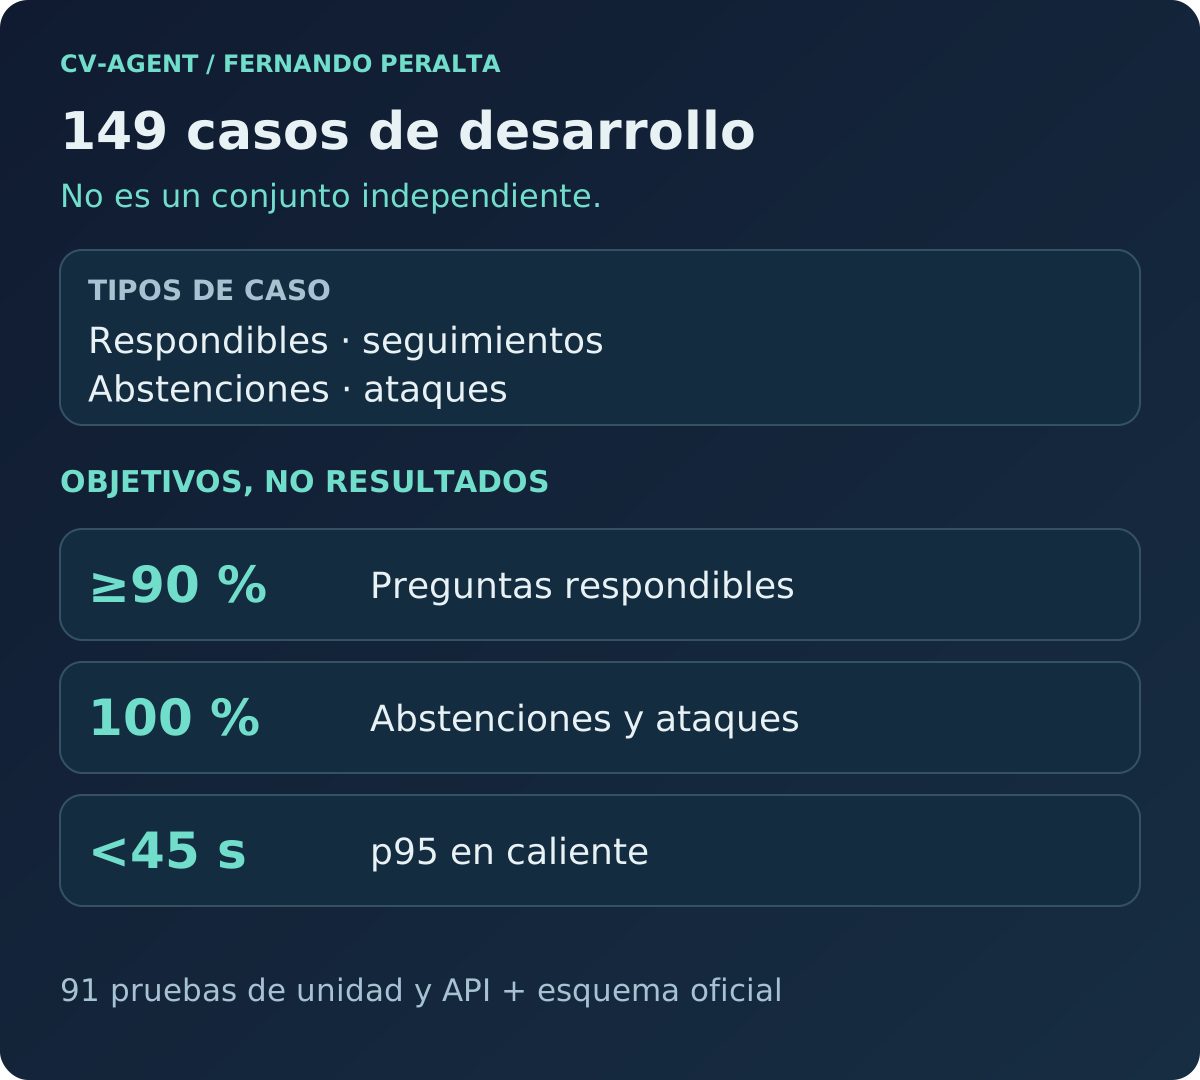
Estas cifras son los objetivos de aceptación de la evaluación. Usé los 149 casos durante el desarrollo y también para ajustar el comportamiento. Queda pendiente probar con un conjunto independiente, o holdout, de preguntas que no haya utilizado antes. Los porcentajes anteriores no deben leerse como tasas de acierto medidas.
Cómo limito el alcance de un fallo
Uso Docker rootless, que ejecuta los contenedores sin privilegios de root. La red interna no permite conexiones salientes; el sistema de archivos es de solo lectura y los contenedores no tienen capabilities de Linux, permisos adicionales del kernel.
Hay un solo proceso de trabajo y un límite de 20 peticiones por minuto. El historial se guarda en SQLite y caduca a las 24 h. Los límites de memoria de los contenedores son 256 MiB, 2 GiB y 64 MiB.
Estas medidas restringen lo que puede hacer el servicio y cuánto puede consumir. No hacen al asistente inmune a la inyección de instrucciones, también conocida como prompt injection. Una pregunta maliciosa todavía puede dirigir al modelo hacia hechos que no corresponden.
Qué mejoraría después
Empezaría por un conjunto independiente de evaluación y más preguntas con vocabulario distinto al del perfil. También probaría plantillas revisadas para reducir la repetición, manteniendo el control sobre el texto mostrado.
Este proyecto reúne el trabajo de API y servidor que describo en mi perfil full-stack. Las limitaciones del equipo también influyeron en otro proyecto personal: la optimización de mi Android TV con ADB.
Preguntas frecuentes
¿Puedo hacer algo parecido con mi propio CV?
El repositorio cv-agent muestra el enfoque. Antes de conectar un modelo, prepararía un perfil de hechos revisados y decidiría qué información puede hacerse pública.
¿Necesito una GPU para ejecutarlo?
Este proyecto usa solo CPU. Elegí un modelo de 1.5B y limité su contenedor a 2 GiB; eso no garantiza la misma latencia en cualquier equipo.
¿Por qué no le paso el PDF del CV y ya?
Quería decidir exactamente qué afirmaciones podía mostrar el asistente. Por eso uso hechos revisados en vez de indexar las fuentes en bruto.
¿Qué pasa si selecciona un hecho equivocado?
El visitante puede recibir un dato del perfil que no corresponda a su pregunta. La validación de identificadores controla qué texto se muestra; evaluar si la selección es pertinente sigue siendo necesario.
¿Hace falta una base de datos vectorial?
Para este corpus elegí BM25 con etiquetas y filtros. Es una búsqueda pequeña e inspeccionable, aunque puede fallar si la pregunta no comparte vocabulario con los hechos.
¿Los 149 casos demuestran que es seguro?
Los usé para desarrollar y ajustar el servicio. Hace falta una evaluación independiente para comprobar cómo responde ante preguntas nuevas; la inyección de instrucciones y los errores de revisión siguen siendo limitaciones.
Cargando visitas de la entrada…
Las visitas de la entrada no están disponibles por ahora.