Blog
Cómo liberé más de 12GB de espacio en mi cuenta de Hotmail con Jev (Ahorrándome una suscripción más)
Liberé más de 12GB en mi Hotmail con Jev: clasifiqué unos 70 mil correos, revisé los dudosos y confirmé el borrado permanente sin pagar otra suscripción de almacenamiento.
En una época en la que acumulamos miles de suscripciones —streaming, almacenamiento en la nube, herramientas de productividad— casi cualquier límite de espacio termina convirtiéndose en otra cuota mensual. Yo tuve este problema con mi cuenta de Hotmail: estaba al límite de almacenamiento y acumulaba alrededor de 70 mil correos. Entre ellos había promociones, boletines, avisos automáticos y mensajes que ya habían perdido su utilidad. También había recibos, accesos y conversaciones que sí necesitaba conservar. Borrar todo por remitente o por antigüedad era demasiado arriesgado; revisar cada mensaje a mano, interminable. En lugar de pagar más almacenamiento, decidí recuperar espacio.
Así nació Mail Organizer: una aplicación local para decidir qué correos podía eliminar, revisar los casos dudosos y ejecutar el borrado desde Outlook. La pieza que me permitió pasar de una limpieza a ciegas a una revisión útil fue Jev, el modelo System One de TypeSafe.
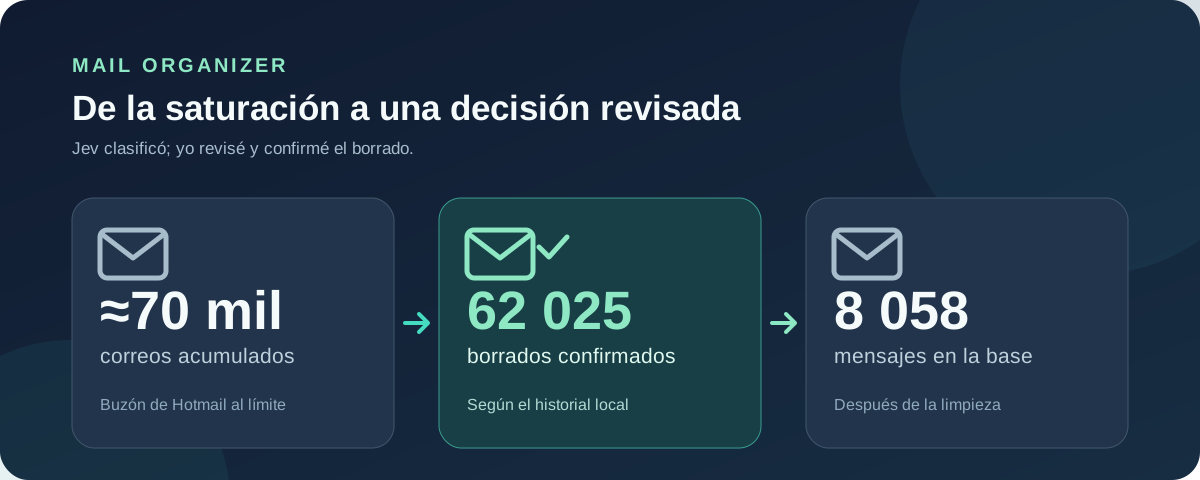
El objetivo no era que una IA vaciara mi buzón. Era reducir miles de decisiones repetitivas a una lista que yo pudiera entender y aprobar.
Las tecnologías que elegí
Quería que la aplicación corriera en mi computadora y que las claves nunca llegaran al navegador. Elegí un solo proyecto Next.js 15 con React 19, TypeScript y Tailwind CSS para la interfaz; sus rutas API ejecutan la lógica del servidor. Así podía construir el panel de revisión y los procesos de limpieza en la misma aplicación, sin desplegar un servicio adicional.
| Pieza | Tecnología | Su trabajo en el proyecto |
|---|---|---|
| Interfaz y servidor | Next.js App Router, React, TypeScript y Tailwind | Mostrar el flujo guiado y ejecutar las rutas API en Node.js. |
| Acceso al correo | Microsoft Graph y @azure/msal-node |
Iniciar sesión, consultar mensajes y solicitar el borrado en Outlook. |
| Juicios de IA | Jev mediante @typesafe-ai/sdk |
Evaluar cada correo y devolver probabilidades estructuradas. |
| Persistencia | SQLite con better-sqlite3 |
Guardar metadatos, juicios, trabajos en curso y el historial de borrados. |
La separación importante está dentro de ese único proceso: el navegador muestra datos y recoge mis decisiones; las rutas API guardan la sesión de Microsoft y la clave de TypeSafe, consultan los servicios externos y escriben en SQLite. Los secretos viven en .env.local y solo se leen del lado del servidor.
También orquesté agentes en Cursor y OpenCode con los modelos GPT-6 Astra, GPT-6 Sol, Opus 5.5, Grok 4.7 y Muse Spark 1.3.
Del buzón saturado a una lista revisable
Dividí el trabajo por rangos de fechas. La aplicación se conecta a Outlook mediante Microsoft Graph y trae a una base SQLite local solo los datos necesarios para clasificar: remitente, asunto, una vista previa breve, fecha, carpeta y algunas señales como si el correo tiene adjuntos. No descarga ni guarda el cuerpo completo o los adjuntos. Si quiero leer un mensaje, la aplicación pide su cuerpo a Outlook en ese momento.
- Panel React Envía acciones a las rutas API de Next.js.
- Rutas API Usan MSAL y la sesión local para hablar con Microsoft Graph.
- Microsoft Graph Devuelve metadatos por rango; la API los guarda en SQLite.
- SQLite → Jev Cada consulta envía un correo; Jev responde con juicios tipados que vuelven a la base.
- Política de protección Filtra las listas que veo en el panel. Al confirmar, la API pide el borrado permanente a Graph.
Guardar los juicios en SQLite fue importante. Pude detener y retomar el proceso sin clasificar dos veces los mismos mensajes. También pude ajustar los umbrales de decisión y recalcular las listas sin volver a consultar a Jev.
Autenticación y sincronización
Para una cuenta personal de Hotmail usé OAuth con MSAL, un cliente público y el flujo Authorization Code + PKCE. La aplicación solicita permisos delegados de correo, comprueba que la cuenta conectada sea la que configuré y mantiene la sesión del lado del servidor. No pide mi contraseña ni usa un client secret en el navegador. Esa lógica vive en auth.ts.
Cada sincronización tiene fechas obligatorias. Internamente convierto las fechas inclusivas de la interfaz en un intervalo [desde, hasta) y consulto Microsoft Graph página por página. Guardo un cursor y el progreso en SQLite para continuar si una sesión se interrumpe. Al volver a sincronizar, actualizo los metadatos sin borrar el hecho de que Jev ya clasificó un mensaje. Eso está en sync.ts y messages.ts.
SQLite cumple otra función: Outlook no conoce mi campo junk_probability, así que no podría filtrar o agrupar los correos por ese valor directamente en Graph. En la base local separé messages (metadatos), judgments (respuestas de Jev), scores (resultado de la política), jobs (progreso) y deletion_log (auditoría). Si cambio un umbral, recalculo scores a partir de judgments sin pagar otra clasificación.
Trabajos largos y una interfaz que explica el progreso
Sincronizar, clasificar y borrar miles de correos tarda más que una petición web normal. Las rutas API inician trabajos en segundo plano dentro del proceso local y devuelven el control al panel. jobs guarda el rango, el cursor y los contadores; cada correo clasificado se persiste en cuanto termina. Si el servidor se reinicia, la aplicación reconoce el trabajo interrumpido y puedo continuarlo sin empezar de cero.
Organicé la interfaz en cinco pasos —conectar, elegir fechas, sincronizar, clasificar y revisar— y añadí un registro de actividad para páginas recibidas, errores y reintentos. Esto resolvió un problema de diseño igual de importante que la clasificación: durante una operación larga necesitaba saber si el sistema avanzaba, esperaba por una cuota o requería que interviniera.
Qué le pregunté a Jev
Una regla como «si dice newsletter, bórralo» no distingue entre publicidad inútil y un correo que todavía necesito. Por eso Jev evalúa cada mensaje por separado con diez preguntas de respuesta estructurada. La principal es, en esencia: «¿Podría eliminar este correo definitivamente sin perder nada que aún necesite?» Su respuesta es un Noul, la pregunta de sí o no de TypeSafe que devuelve una probabilidad entre 0 y 1. Esa probabilidad alimenta la lista de mensajes prescindibles.
Este fragmento del clasificador (classify.ts) muestra la idea central: envío el contexto de un correo junto con las diez preguntas y leo una respuesta tipada, sin interpretar texto libre.
const response = await typeSafe().systemOne({
  state: stateFor(message, folders, evaluatedAt),
  model: "jev-latest",
  questions: MAIL_QUESTIONS,
});

const probability = response.answers.is_disposable.noul;
Las otras preguntas aportan contexto y protección: si parece marketing o un aviso automático, si una persona espera respuesta, si contiene credenciales, si es un comprobante financiero o legal, y si su utilidad ya caducó. Para los casos que dependen del tiempo, Jev recibe tanto la fecha del correo como la fecha de evaluación. Un código temporal de hace años y una factura del mismo día no deberían tratarse igual.
La aplicación hace una consulta a Jev por correo, pero incluye las diez preguntas en esa misma consulta. Nueve son Noul y la décima puntúa cuánto dolería perder el mensaje en una escala de cinco niveles. Limité la clasificación a 15 consultas simultáneas y 900 inicios por minuto; los errores transitorios se reintentan y los mensajes que siguen fallando quedan identificados para volver a procesarlos. Los patrones como no-reply solo adelantan un correo en la cola: nunca lo declaran basura por sí mismos.
| Resultado del juicio | Qué hacía yo con él |
|---|---|
| 75 % o más de probabilidad de ser prescindible | Aparecía como eliminable, listo para mi revisión. |
| 40 % a menos de 75 % | Iba a revisar: la decisión necesitaba más contexto. |
| Menos de 40 % | Quedaba en conservar. |
Ese porcentaje es un juicio del modelo, no una garantía de que borrar sea seguro. Por eso añadí frenos independientes: un correo con señales fuertes de credenciales, documentos financieros o legales, o una conversación personal pasa a conservar aunque Jev lo considere prescindible. También puedo proteger remitentes con una lista blanca. Antes de borrar muchos mensajes, la aplicación permite etiquetar una muestra de hasta cien correos y comparar mis decisiones con las de Jev para detectar falsos positivos.
En términos de código, la política (policy.ts) se parece a esto (versión abreviada):
const probability = judgment.is_disposable;
const protectedMail =
  judgment.contains_access_credentials > 0.60 ||
  judgment.contains_financial_or_legal > 0.60 ||
  judgment.is_addressed_personally > 0.70 ||
  senderRule === "always_keep";

const bucket = protectedMail ? "keep"
  : probability >= 0.75 ? "deletable"
  : probability >= 0.40 ? "review"
  : "keep";
Esta división fue deliberada: Jev aporta los juicios; una función determinista aplica mis umbrales y protecciones. Así puedo cambiar la política sin cambiar las respuestas del modelo, y puedo explicar por qué un correo quedó en cada lista.
El paso que realmente liberó espacio
Clasificar no recupera almacenamiento por sí solo. Primero inspeccioné las listas, agrupé correos por remitente y revisé los mensajes dudosos. Para borrar, la aplicación muestra los bloqueos de protección y me exige escribir la cantidad exacta de correos seleccionados. Solo entonces envía a Microsoft Graph la operación de borrado permanente. Mover mensajes a Elementos eliminados no bastaba para el problema de cuota.
Si quieres replicar algo parecido, la operación clave es permanentDelete: Microsoft Graph la expone mediante POST /me/messages/{id}/permanentDelete y, para una cuenta personal, requiere el permiso delegado Mail.ReadWrite. La documentación explica que el mensaje pasa a la carpeta Purges dentro de Elementos recuperables. Esto no significa que desaparezca físicamente al instante: pueden aplicarse políticas de retención.
Antes de llamar a Graph escribo una fila pending por cada mensaje en deletion_log. Después envío permanentDelete en lotes de hasta 20 operaciones, usando identificadores inmutables para que un movimiento entre carpetas no cambie la referencia al correo. Solo una respuesta exitosa marca el registro como deleted; un 404 o una respuesta incierta conserva el caso para revisión o reintento. Ese flujo está en deletion.ts.
Durante la limpieza masiva apareció otro obstáculo: Microsoft limita la velocidad de las peticiones. El borrado se volvió lento cuando alcancé esa cuota. Incorporé un presupuesto preventivo de 9 000 operaciones por diez minutos y una espera compartida cuando Microsoft responde con Retry-After. El proceso reenvía únicamente los elementos que fallaron, sin repetir los borrados ya confirmados. El panel muestra si está esperando por la cuota y el registro conserva el resultado de cada correo; un error de red no se presenta como un borrado exitoso.
Resultado registrado: al 22 de septiembre de 2026, el historial local marcaba 62 025 correos distintos como borrados y cero pendientes o fallidos. La base local conservaba 8 058 mensajes. Jev usó 100 737 845 tokens, con un costo de 3.6393 dólares.
Lo que empezó como un buzón imposible de ordenar terminó en un flujo manejable: acotar fechas, pedir a Jev juicios claros, proteger lo valioso, revisar y confirmar el borrado. Jev me ahorró la clasificación repetitiva; las reglas y la revisión humana me ayudaron a conservar el control de la decisión final.
Para profundizar
- Qué es Jev y cómo funciona, en la documentación oficial de TypeSafe.
- Noul, Score y Choice, las respuestas estructuradas con las que construí la clasificación.
- Referencia de la API System One, para ver el contrato de las consultas.
- Borrado permanente de mensajes (Microsoft Graph), guía oficial con los permisos y la carpeta de purgas.